Een lerend gezondheidszorgsysteem voor beter kankeronderzoek en betere zorg voor mensen met kanker
Elke dag worden er tijdens de diagnose en behandeling van kanker enorme hoeveelheden gegevens gegenereerd. Weefselmonsters worden geanalyseerd, er worden gegevens over het genoom van de tumor verzameld, behandelingen worden voorgeschreven en de resultaten worden gevolgd.
De inzichten die deze gegevens opleveren, zijn waardevol voor individuele patiënten, maar hebben – met inachtneming van de rechten en keuzes van patiënten met betrekking tot het gebruik van hun gegevens – ook het potentieel om onderzoek en innovatie te stimuleren en zo de zorg voor toekomstige patiënten te verbeteren.
Het verbeteren van deze ‘gegevenskringloop’ is een gezamenlijke missie van Hartwig Medical Foundation en het Oncode Accelerator Patient Cohorts Platform. Samen streven zij ernaar de routinematige zorg voor patiënten met kanker om te vormen tot een lerend gezondheidszorgsysteem dat onderzoek versnelt, behandelingsbeslissingen verbetert en betere zorg biedt aan toekomstige patiënten.
Op een dag zouden we een lerend gezondheidszorgsysteem kunnen hebben waarin elke patiënt bijdraagt aan het verbeteren van de zorg voor de volgende patiënt met kanker. Dat is een visie die Hartwig Medical Foundation en het Oncode Accelerator Patient Cohorts Platform delen.
Zij werken samen om gegevens uit het gehele traject van de zorg voor patiënten met kanker met elkaar te verbinden, waaronder longitudinale klinische gegevens en uitkomst gegevens, genomische informatie en gegevens over de kwaliteit van leven, zodat deze zowel als leidraad kunnen dienen voor diagnose en behandeling als voor het bevorderen van onderzoek en de ontwikkeling van nieuwe therapieën.
We spraken met Paul Roepman (klinisch moleculair bioloog, Hartwig Medical Foundation), Joep de Ligt (databasemanager, Hartwig Medical Foundation) en Elise Rinzema (programmamanager, Patient Cohorts Platform van Oncode Accelerator) om hier meer over te weten te komen. “Ieder van ons draagt een ander stukje van de puzzel bij”, legt Elise uit.
Het Patiëntencohorten platform brengt twaalf nationale oncologiecohorten samen, die hoogwaardige klinische gegevens en biomateriaal verzamelen van patiënten met kanker in heel Nederland. Hartwig Medical Foundation is gespecialiseerd in het opstellen van een volledig genoomprofiel van de kanker en het vertalen van deze complexe moleculaire gegevens naar informatie die betekenisvol is voor artsen, patiënten en onderzoekers.
Paul voegt hieraan toe: “Hartwig Medical Foundation is een technologie-instituut. We zijn afhankelijk van samenwerkingsverbanden met ziekenhuizen – en bij voorkeur op grote schaal, zoals bij het Patient Cohorts Platform, want de aantallen zijn van belang.”
Van routinezorg naar een lerend gezondheidszorgsysteem
“In elk ziekenhuis zijn er enorm veel gegevens beschikbaar. Idealiter kun je daaruit inzichten halen om onderzoek en toekomstige gezondheidszorg te verbeteren, vervolgens de behandelingen voor huidige patiënten te verbeteren en daarna weer te leren van de patiënten die de verbeterde behandelingen ontvangen“, zegt Elise.
“Maar onderzoek en routinezorg opereren vaak los van elkaar. Om ze samen te brengen zijn coördinatie en vertrouwen nodig.“
Diagnostische informatie helpt bijvoorbeeld bij het nemen van beslissingen voor individuele patiënten, maar het potentieel ervan om nieuwe inzichten te genereren en behandelingen voor toekomstige patiënten te verbeteren, wordt niet altijd ten volle benut. Hoewel klinische onderzoeken cruciaal blijven voor de ontwikkeling van nieuwe behandelingen, streeft een lerend gezondheidszorgsysteem ernaar deze aan te vullen door systematisch te leren van alle patiënten die in de dagelijkse klinische praktijk zorg ontvangen.
“In een ideale situatie leer je van elke patiënt”, zegt Paul.
“In een lerend gezondheidszorgsysteem willen we weten of een behandeling heeft gewerkt, voor wie en waarom. Die inzichten moeten worden teruggekoppeld naar onderzoek en zorg, zodat we kunnen leren van onze successen en fouten en de zorg voor toekomstige patiënten kunnen verbeteren.”
De gegevenskringloop sluiten
Het sluiten van deze gegevenskringloop tussen zorg en innovatie is een noodzakelijke stap in de richting van het creëren van een lerend gezondheidszorgsysteem. “Het gaat erom ervoor te zorgen dat gegevens die tijdens de zorg worden gegenereerd, weer worden gebruikt voor onderzoek, klinische proeven en de herevaluatie van geneesmiddelen”, legt Joep uit.
“Zo moeten bijvoorbeeld gegevens van verschillende ziekenhuizen over hoe lang patiënten na een bepaalde behandeling overleven, worden verzameld, gebundeld en geanalyseerd om te achterhalen hoe goed de behandeling heeft gewerkt. En vervolgens moeten de bevindingen van die herevaluatie weer worden verwerkt in de behandelrichtlijnen.”
Paul en Joep geven twee voorbeelden die laten zien hoe deze feedbackloop patiënten ten goede kan komen. Het eerste voorbeeld betreft PARP-remmers, een behandeling voor patiënten met borst- of eierstokkanker. “Van oudsher werd aangenomen dat PARP-remmers het beste werken bij patiënten met borst- of eierstokkanker die mutaties in de BRCA-genen hebben. Dit kwam ook tot uiting in de bijsluiter van het medicijn,” legt Paul uit.
“Maar door gegevens van volledige genoomsequencing van patiënten te analyseren, kwamen we erachter dat PARP-remmers goed werken tegen tumoren met een groot aantal DNA-breuken, die weliswaar, maar niet uitsluitend, veroorzaakt kunnen worden door defecten in BRCA-genen. PARP-remmers werken minder goed bij tumoren die niet veel DNA-breuken vertonen, zelfs als ze wel een BRCA-mutatie hebben.” Dit nieuwe inzicht zal artsen helpen om in de toekomst betere behandelingsbeslissingen te nemen en de bijsluiters aan te passen.
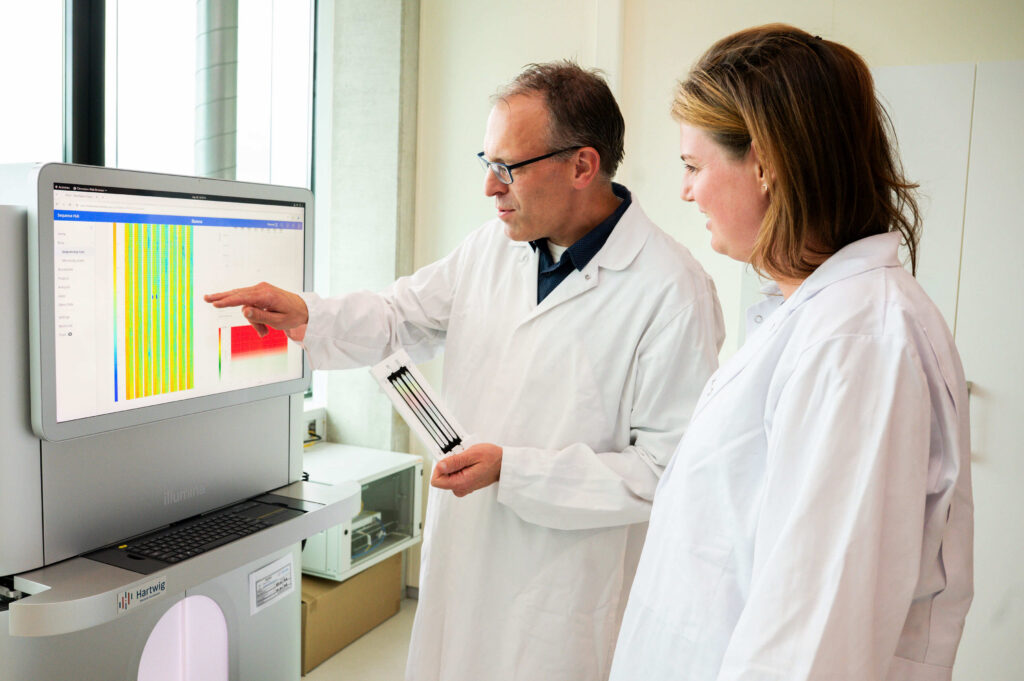
Een tweede voorbeeld is kanker met onbekende primaire tumor (PTO): gevallen waarin de kanker is uitgezaaid, maar de oorsprong ervan niet kan worden vastgesteld. Vroeger betekende dit dat er geen standaardbehandeling beschikbaar was, omdat behandelingsschema’s, waaronder chemotherapieën, worden afgestemd op de oorspronkelijke tumorlocatie.
“Met behulp van gegevens uit volledige genoomsequencing kunnen we nu bij ongeveer drie op de vier patiënten met PTO beter achterhalen waar de primaire tumor zich bevindt”, legt Paul uit.
Deze aanpak, die inmiddels wordt vergoed binnen de Nederlandse gezondheidszorg, opent behandelingsmogelijkheden voor patiënten die anders geen enkele kans hadden.
Waar de gegevensstroom nog steeds onderbroken wordt
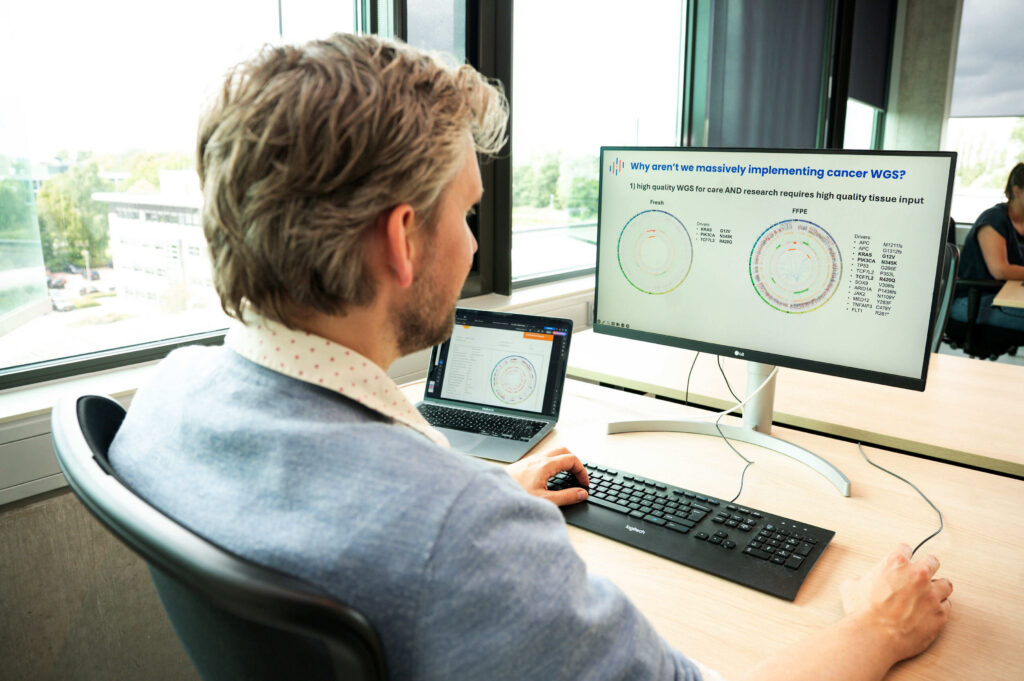
Om conclusies te kunnen trekken moeten zowel biologische monsters als klinische informatie aan hoge kwaliteitsnormen voldoen. Voor biologische biopten is de wijze van afname en opslag cruciaal. Zo vereist routinematige histopathologie bijvoorbeeld dat biopten met formaline worden gefixeerd voor microscopisch onderzoek – maar dit proces beschadigt het DNA, waardoor die biopten minder geschikt zijn voor genomische analyse.
Gegevens uit biologische biopten en bijbehorende klinische gegevens van dezelfde patiënt moeten ook aan elkaar worden gekoppeld, zodat duidelijk is welke biopten van welke patiënt afkomstig zijn.
Wat klinische gegevens betreft is het belangrijk dat informatie op een nauwkeurige, volledige en gestandaardiseerde manier wordt vastgelegd. “Als overlevings- of behandelingsgegevens onnauwkeurig of onvolledig zijn“, legt Joep uit, “lopen onderzoekers het risico verkeerde conclusies te trekken.“
Gegevensstandaardisatie is ook van cruciaal belang om ervoor te zorgen dat gegevens uit verschillende ziekenhuizen effectief kunnen worden gecombineerd. “We moeten allemaal dezelfde taal spreken“, zegt Elise. “Door verschillende datasets te combineren, worden de gegevens veel waardevoller.“ Gegevensstandaardisatie maakt het bijvoorbeeld gemakkelijker om zeldzame vormen van kanker te bestuderen, waarvoor de totale hoeveelheid gegevens zeer beperkt is.
Door gegevens uit verschillende bronnen vergelijkbaar te maken, zodat ze gemakkelijk kunnen worden gecombineerd en geanalyseerd, kan informatie van voldoende patiënten in Nederland of wereldwijd worden gebundeld om zinvolle inzichten te genereren.
Complexe gegevens begrijpelijk maken
Elke dataset van volledige genoomsequencing bevat een enorme hoeveelheid informatie. Paul zegt hierover: “Een deel van mijn taak is ervoor te zorgen dat de gegenereerde genomische gegevens en resultaten aansluiten bij wat ziekenhuizen nodig hebben, willen en aankunnen, om artsen te ondersteunen – en niet in verwarring te brengen – bij het voeren van een zinvol gesprek met hun patiënten in de spreekkamer.
We rapporteren en prioriteren doorgaans resultaten voor een subset van ongeveer 500 kankergerelateerde genen en genoombrede markers, zoals de mutatiebelasting van de tumor en microsatellietinstabiliteit, om de hoeveelheid informatie beheersbaar te houden.”
Waarom worden alleen deze geselecteerde markers en behandelingsgerelateerde bevindingen gerapporteerd, en niet alles? “Als je alle gegevens die uit volledige genoomsequencing voortkomen zou willen bekijken, zou dat zelfs voor een expert dagen duren“, legt Joep uit.
“We hebben het team van Paul nodig om te helpen bepalen wat klinisch relevant is. Als het aantal genetische mutaties bijvoorbeeld voorspellend is voor de vraag of een immuuntherapie bij een patiënt zal werken, is dat belangrijke informatie. Maar een arts wil geen ruw getal zien, hij wil weten: zal deze therapie mijn patiënt helpen?”
Om onderzoekers en clinici te helpen hun weg te vinden in die grote datasets en praktische vragen te beantwoorden, zoals welke therapie voor welke patiënt geschikt is, ontwikkelt het team van Joep bij Hartwig Medical Foundation nieuwe hulpmiddelen, zoals AI-assistenten die onderzoekers en artsen helpen de beschikbare gegevens te gebruiken om hun vragen te beantwoorden.
Belangrijk is dat bij het ontwerpen van deze tools voor gegevensanalyse en visualisatie privacy voorop staat. “Onze AI-assistent helpt bij het beantwoorden van vragen op basis van de beschikbare gegevens, maar heeft nooit rechtstreeks toegang tot patiëntgegevens“, legt Joep uit.
Dit waarborgt de naleving van strenge gegevensbeschermingsvereisten en respecteert de toestemming van de patiënten en hun recht om hun gegevens in te trekken. Het doel is om de gegevens gemakkelijker analyseerbaar te maken zonder afbreuk te doen aan de veiligheid of de privacy van patiënten.
Samen bouwen aan de toekomst
Het sluiten van de gegevenskringloop vereist toonaangevende technologie en expertise, maar ook vertrouwen en samenwerking. Het standaardiseren van gegevens, het op elkaar afstemmen van systemen en het creëren van gemeenschappelijke kaders tussen zoveel uiteenlopende partners kan een moeizaam proces zijn, maar de potentiële voordelen zijn groot.
Afzonderlijk beschikken Hartwig Medical Foundation en het Patient Cohorts Platform elk over verschillende stukjes van de puzzel. Maar samen kunnen ze de gegevenskringloop sluiten en een gezondheidszorgsysteem opbouwen waarin elke patiënt bijdraagt aan betere zorg voor de volgende.
Uitgelichte foto: LaloesFotografie
U las een artikel over het onderwerp Lerend zorgsysteem. Wellicht bent u ook geïnteresseerd in Algoritmes, Behandeling op maat, DNA, Educatie, Hartwig Medical Database, Hartwig Medical Foundation, Hergebruik data, Moleculaire diagnostiek, OncoAct, Primaire Tumor Onbekend of Zeldzame kankers.Alle nieuwsberichten
Lees ook
Uitgebreid DNA-onderzoek helpt bij bepalen primair tumor type en vinden van passende behandeling
Bij een klein percentage van patiënten met uitzaaiingen van kanker kan de oorspronkelijke tumor niet gevonden worden. Het is dan …

Patiënt profiteert van meer specialisatie in de kankerzorg
De behandelmogelijkheden nemen snel toe. Medisch specialisten in de kankerzorg moeten zich daarom verder specialiseren. Dat zegt Irene Dingemans van …
Onderzoek gepubliceerd in Nature: Darmbacterie kan kanker veroorzaken
Onder Hans Clevers, hoogleraar in de moleculaire genetica en stamcelonderzoeker aan het Hubrecht instituut en Ruben van Boxtel, hoofdonderzoeker bij Princess …

Zolang de behandelaar niet weet waar de primaire tumor zit, heeft hij ook geen gerichte behandelmogelijkheid en kan ook geen inschatting worden gegeven hoe lang iemand nog heeft.